Как выбрать компьютер для нейросетей и ИИ
Привет, читатель.
Представим три задачи. Первая — весь день работать в ChatGPT и иногда делать картинки в браузере. Вторая — запустить свою модель и разбирать на ней пачки документов. Третья — каждый день генерировать видео в ComfyUI. Во всех трёх случаях компьютер нужен «для ИИ», но покупать для них одинаковое железо я бы не стал.
Для первой задачи вполне подойдёт обычный рабочий ПК или даже ноутбук. Для второй я сначала выясню, какую модель нужно запустить и сколько текста она будет читать за один раз. Для третьей спрошу про разрешение, длину ролика и сколько времени можно ждать генерацию. Только потом буду смотреть, какая видеокарта влезает в бюджет.
Содержание
- Какой компьютер нужен для работы с ИИ
- Когда можно обойтись без дискретной видеокарты
- Сколько видеопамяти нужно для локальных языковых моделей
- Пример 1. Локальный помощник по инструкциям и договорам
- Какую видеокарту выбрать для ComfyUI, FLUX и генерации видео
- Пример 2. Карточка товара с референсом и финалом в 4K
- Пример 3. Сделать рекламный ролик из фотографии
- Подойдёт ли этот ПК для обучения нейросетей
- NVIDIA или AMD для локального ИИ
- Как подобрать процессор, оперативную память и SSD
- Три примера конфигураций для работы с ИИ
- Простая сборка для локального чата, картинок и аудио
- Средняя сборка для ежедневной работы с ИИ
- Флагманская станция для крупных моделей, видео и дообучения
- Частые вопросы
- Что замерить на рабочей задаче перед покупкой
- Как заказать компьютер для нейросетей
Какой компьютер нужен для работы с ИИ
| Что вы делаете | С чего я бы начал |
|---|---|
| Пользуетесь ChatGPT, Claude или другими облачными сервисами | Обычный ПК со встроенной графикой, 16–32 ГБ оперативной памяти |
| Запускаете локальный чат, расшифровываете записи, делаете картинки | GeForce RTX 5060 Ti 16 ГБ, 32–64 ГБ оперативной памяти, SSD 2 ТБ |
| Каждый день генерируете изображения в ComfyUI | GeForce RTX 5070 Ti 16 ГБ или NVIDIA RTX PRO 4000 Blackwell 24 ГБ, 64 ГБ оперативной памяти, SSD 2–4 ТБ |
| Запускаете модели на 27–32 млрд параметров с длинным контекстом или регулярно генерируете видео | GeForce RTX 5090 32 ГБ или NVIDIA RTX PRO 5000 48G, 96–128 ГБ оперативной памяти, SSD 4 ТБ |
| Запускаете крупную модель для команды или работаете с тяжёлыми видео и дообучением | Подбор под конкретную модель, программу и нагрузку. Отправная точка — одна карта на 48–96 ГБ либо несколько карт, если движок умеет распределять работу |
Смотреть на видеокарты я бы начал с двух вопросов. Поместится ли модель вместе с рабочими данными в память? И сколько времени она будет считать после того, как поместится? Первая часть определяет, что вы сможете запускать. Вторая — насколько удобно будет этим пользоваться.
Когда можно обойтись без дискретной видеокарты
Если вы открываете ChatGPT в браузере, ответ считает сервер сервиса. То же самое происходит, когда вы генерируете изображения в облачном интерфейсе или вызываете модель через облачный API. Видеокарта в вашем ПК рисует окно браузера, а требования к самому компьютеру определяются тем, что ещё открыто рядом. Для браузера, почты и документов хватит 16 ГБ оперативной памяти. Если весь день работают десятки вкладок, IDE и несколько приложений одновременно, я бы взял 32 ГБ.
Даже внутри одной программы режимы могут различаться. В ComfyUI можно поставить локальную модель, которую считает ваша видеокарта, или подключить облачную модель через партнёрский узел. Перед апгрейдом выясните, где выполняется именно ваш сценарий. Документация ComfyUI.
С локальным запуском появляется другая возможность. Можно держать модель, документы и индекс на своём компьютере. Например, загрузить инструкции компании, искать в них нужные фрагменты и просить модель отвечать по этим фрагментам. Такой подход называется RAG. Если данные должны оставаться внутри компании, проверьте, где работают поиск по документам, модель для построения эмбеддингов, сам чат и подключённые к нему инструменты. Каждый из этих компонентов может иметь свой способ подключения. Документация Open WebUI по RAG · Документация Ollama по эмбеддингам.
Сколько видеопамяти нужно для локальных языковых моделей
Когда вы скачиваете модель для Ollama или LM Studio, первое число, которое видите, — размер файла. Он даёт хороший ориентир для оценки объёма весов. При запуске движку также нужна память на KV-кэш и рабочие буферы, а часть видеопамяти может быть занята системой и другими приложениями. KV-кэш хранит промежуточные данные о токенах, которые модель уже обработала. Длиннее переписка или больше текста в запросе — больше места может занять кэш. Если станция обслуживает несколько запросов одновременно, это тоже приходится учитывать. Контекст в Ollama · Параллельные запросы и KV-кэш в Ollama.
Здесь ещё важно квантование. Один и тот же Qwen3-32B в GGUF можно скачать в Q4_K_M на 19,8 ГБ, Q5_K_M на 23,2 ГБ или Q8_0 на 34,8 ГБ. При более сильном сжатии веса занимают меньше места, а насколько это скажется на ответах, лучше проверять на своих задачах. Для извлечения фактов из однотипных документов и генерации кода выводы могут отличаться. Файлы Qwen3-32B от разработчика модели.
Почему Qwen3-32B может упереться в 24 ГБ
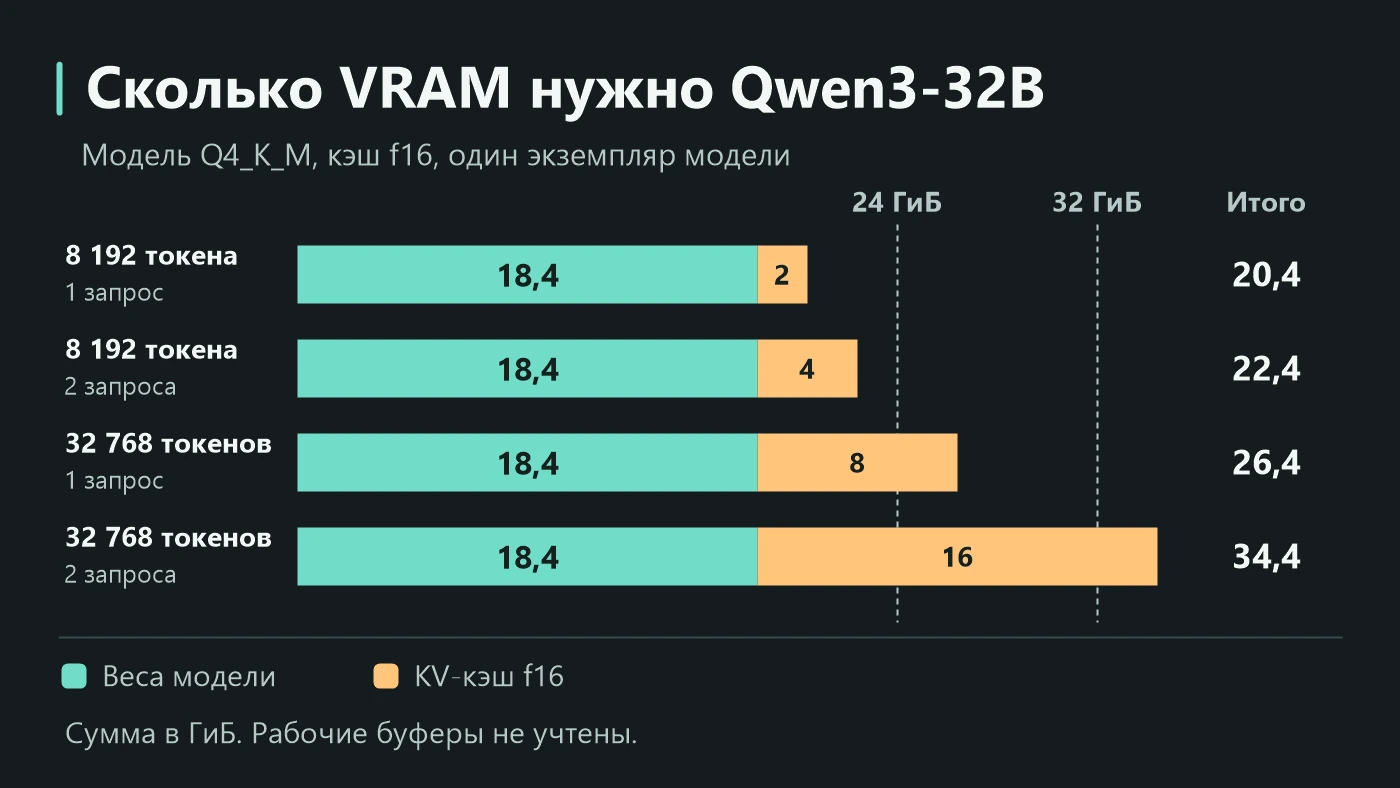
Возьмём Qwen3-32B в Q4_K_M. 19,8 ГБ файла — это примерно 18,4 ГиБ. У этой модели стандартный KV-кэш f16 на один запрос занимает примерно 2 ГиБ при 8 192 токенах и 8 ГиБ при 32 768 токенах. Это оценка по архитектуре модели. С коротким контекстом веса и кэш занимают около 20,4 ГиБ. С длинным уже 26,4 ГиБ, ещё до рабочих буферов. Вот откуда берётся разница между «запустил и пообщался» и «загрузил большой отчёт и жду ответ». Параметры Qwen3-32B для расчёта · Квантование KV-кэша в Ollama.
На практике можно сократить контекст, взять другую версию модели или уменьшить размер кэша, если движок это поддерживает. Ollama также умеет размещать часть модели в оперативной памяти и задействовать процессор. Такой запуск обычно медленнее, особенно когда на CPU приходится существенная доля вычислений. Команда ollama ps показывает фактический контекст и распределение между GPU и CPU. Если подбираете компьютер по тесту, смотрите и на время до первого токена, и на скорость дальнейшей генерации. Первое вы почувствуете, пока модель читает длинное письмо. Второе — пока она печатает ответ. Проверка контекста и размещения модели в Ollama · Поля замеров в API Ollama.
Пример 1. Локальный помощник по инструкциям и договорам
Допустим, в компании хотят поставить локальный чат для двух сотрудников. Один спрашивает, как оформить гарантийное обращение, другой ищет пункт в договоре. В базе лежат инструкции, договоры и сканы. Для выбора ПК нам нужно знать, сколько текста система подставляет в каждый запрос и должны ли оба сотрудника получать ответы одновременно.
В простом сценарии RAG система находит отрывки в базе и передаёт их модели вместе с вопросом. Пять отрывков примерно по 1 000 токенов займут около 5 000 токенов. При окне в 8 192 остаётся примерно 3 200 на инструкции, историю, вопрос и сам ответ. Если система передаёт ещё и переписку за неделю, это окно легко заполнить. Уменьшать число отрывков вслепую тоже плохая идея. Когда условие гарантии разбросано между основным текстом и приложением, поиск должен найти оба места. Как Open WebUI добавляет результаты поиска в контекст.
Теперь считаем память. Возьмём тот же Qwen3-32B Q4_K_M. Веса занимают около 18,4 ГиБ. Для этой модели каждые 4 096 токенов выделенного контекста требуют ещё примерно 1 ГиБ кэша f16 на один запрос. Из чего получается число? В модели 64 слоя, в каждом по 8 KV-голов размерностью 128. Для каждого токена храним ключи и значения, по 2 байта на элемент. Получаем 2 × 64 × 8 × 128 × 2 = 262 144 байта, или 256 КиБ на токен. Это оценка для конкретной архитектуры и формата кэша. Конфигурация Qwen3-32B · Файлы модели.
| Выделенное окно на запрос | Параллельных запросов | Кэш f16 | Веса и кэш |
|---|---|---|---|
| 8 192 токена | 1 | ≈ 2 ГиБ | ≈ 20,4 ГиБ |
| 8 192 токена | 2 | ≈ 4 ГиБ | ≈ 22,4 ГиБ |
| 32 768 токенов | 1 | ≈ 8 ГиБ | ≈ 26,4 ГиБ |
| 32 768 токенов | 2 | ≈ 16 ГиБ | ≈ 34,4 ГиБ |
Здесь предполагаем одну загруженную копию модели. У каждого одновременного запроса свой контекст. В таблицу ещё не вошли рабочие буферы движка и память, которую заняли другие приложения. Поэтому на карте с 24 ГБ я бы сначала проверил один запрос с окном 8 192 и очередью. На RTX 5090 с 32 ГБ логично проверить один запрос с окном 32 768. Если два сотрудника регулярно запускают такие запросы одновременно, под расчёт с f16 я бы уже смотрел на NVIDIA RTX PRO 5000 48G. Как Ollama выделяет память для одновременных запросов.
Перед покупкой можно проверить и другой путь. В Ollama с Flash Attention доступен кэш q8_0. Он занимает примерно вдвое меньше места, чем f16. При двух запросах по 32 768 токенов это снижает оценку с 34,4 примерно до 26,4 ГиБ до учёта буферов. Тогда снова имеет смысл испытать карту с 32 ГБ. Если сократили число отрывков, проверьте и размер окна в настройках движка. Меньший фактический запрос быстрее обработается, но при прежнем выделенном окне резерв под кэш может остаться тем же. Настройки Flash Attention и KV-кэша Ollama · Как проверить выделенный контекст.
Как я бы проверял результат. Взял бы несколько вопросов с заранее известными ответами, две редакции одного договора и пару вопросов, на которые в базе ответа нет. Если система достаёт просроченное приложение или пропускает абзац из скана, сначала проверяем OCR, разбиение на фрагменты и поиск. Если нужный отрывок найден, но пользователи долго ждут, повторяем те же запросы по одному и парами, смотрим распределение GPU/CPU в ollama ps и замеряем время до первого видимого текста и до полного ответа. Сравнивать карты стоит с одним и тем же квантованием, размером контекста и режимом рассуждений. Движок может начать считать раньше, чем интерфейс покажет первый текст. Диагностика RAG в Open WebUI · Поля времени обработки в API Ollama.
Как измерить скорость обработки запроса и генерации ответа
У языковой модели есть две разные фазы. Сначала она обрабатывает весь входной текст и строит кэш. Это prefill. Затем модель выдаёт ответ по токенам, последовательно. Это decode. При длинном новом запросе на первой фазе большое значение имеет вычислительная производительность. При генерации одного ответа скорость часто ограничена тем, как быстро видеокарта читает веса и кэш из памяти. При нескольких запросах, длинном ранее обработанном контексте и разных настройках движка баланс меняется. Разбор фаз генерации от NVIDIA.
У RTX 5090 с 32 ГБ заявленная пропускная способность памяти составляет 1 792 ГБ/с, у NVIDIA RTX PRO 5000 48G — 1 344 ГБ/с. Это характеристики памяти. По ним одним нельзя посчитать, сколько токенов в секунду выдаст Ollama. Если модель с нужным контекстом полностью помещается в 32 ГБ, у RTX 5090 есть основания быть быстрее. Если часть модели на ней уходит в оперативную память, а на NVIDIA RTX PRO 5000 48G всё остаётся на GPU, больший объём памяти может дать лучший результат. Прогоняем один рабочий запрос и смотрим время до начала ответа и скорость выдачи. Архитектура и характеристики GeForce RTX Blackwell · Спецификация NVIDIA RTX PRO 5000.
Какие модели рассматривать под разный объём VRAM
| Видеопамять | Пример задачи и модели |
|---|---|
| 8 ГБ | Компактный локальный чат. Например, Qwen3 8B, у которого пакет Ollama занимает 5,2 ГБ. Начните с короткого контекста. |
| 12–16 ГБ | Qwen3 14B, пакет 9,3 ГБ. На 16 ГБ можно пробовать gpt-oss 20B, пакет 14 ГБ, и подбирать контекст под остаток памяти. |
| 24 ГБ | Qwen3.5 27B Q4_K_M, пакет 17 ГБ, или Qwen3-32B Q4 с умеренным контекстом. |
| 32 ГБ | Для моделей этого класса остаётся больше места под длинный запрос, рабочие буферы и менее сжатые веса. Настройки по-прежнему влияют на результат. |
| 48–96 ГБ | Llama 3.3 70B в Q4_K_M весит 43 ГБ. Для одной карты на 48 ГБ стоит начать с умеренного контекста. Больший объём нужен под длинные запросы, параллельную работу и модели вроде gpt-oss 120B. |
Размеры относятся к указанным пакетам. Версия модели, тип кэша и параллельная нагрузка меняют требования даже при одинаковом количестве параметров. Qwen3 · Qwen3.5 27B Q4_K_M · gpt-oss · Llama 3.3 70B Q4_K_M.
Как понять, хватит ли модели поменьше
Допустим, вы хотите разбирать заявки в мастерскую. Из каждой нужно достать модель устройства, серийный номер и описание неисправности. Возьмите 20–30 обезличенных заявок, включая записи с опечатками и пустыми полями. Для каждой заранее заполните правильный результат. Затем дайте одинаковые входные данные Qwen3-14B Q8_0 и Qwen3-32B Q4_K_M, если можете запустить обе версии. Считайте верно извлечённые поля, пропуски и выдуманные значения. Попросите оставлять отсутствующие поля пустыми. Ollama умеет ограничить ответ JSON-схемой, поэтому корректный формат можно проверять отдельно от самих значений. Структурированный вывод в Ollama · Как строить проверку качества модели.
Версия 14B Q8_0 весит 15,7 ГБ, а 32B Q4_K_M — 19,8 ГБ. Это размеры файлов без кэша и рабочих буферов. Если меньшая модель справляется с вашими заявками и требует столько же ручных исправлений, можно покупать ПК под неё. Если хотите понять, влияет ли именно квантование, сравните одну модель в Q4 и Q5 на тех же заявках. Файлы Qwen3-14B · Файлы Qwen3-32B.
Почему модели с 3 млрд активных параметров может понадобиться больше 16 ГБ
У моделей MoE, или «смеси экспертов», для каждого токена выбирается только часть сети. У Qwen3.6-35B-A3B около 3 млрд параметров активны при обработке токена, но всего их 35 млрд. Следующий токен может задействовать другие части модели, поэтому для запуска целиком на GPU закладываем память под все веса. Пакет этой модели в Ollama весит около 23 ГБ ещё до кэша и буферов. Число активных параметров помогает понять объём вычислений на токен. Для выбора видеокарты сначала смотрим на размер конкретных весов. Карточка Qwen3.6-35B-A3B · Пакет в Ollama.
Какую видеокарту выбрать для ComfyUI, FLUX и генерации видео
Изображения и обработка фотографий
Здесь память расходуется сразу на несколько вещей. Движок загружает веса генератора, отдельно обрабатывает текст, декодирует итоговую картинку. Затем вы добавляете референсы, дорисовку участка, апскейл или отправляете сразу несколько изображений в пакет. Две схемы ComfyUI с одной и той же моделью в итоге могут требовать разный объём памяти. Документация ComfyUI по FLUX 3 Image Klein · Управление памятью в Diffusers.
Black Forest Labs указывает, что FLUX 3 Image Klein INT8 запускается на GeForce RTX с 8 ГБ видеопамяти. Это хороший повод начать с карты, которая у вас уже есть. Для нового компьютера под регулярную работу я бы смотрел на 16 ГБ. Будет больше свободы по разрешению, дополнительным узлам и моделям, которые хочется попробовать. Если генерация идёт партиями в течение дня, тогда есть смысл доплачивать за более быстрый GPU. Black Forest Labs о запуске FLUX 3 Image Klein.
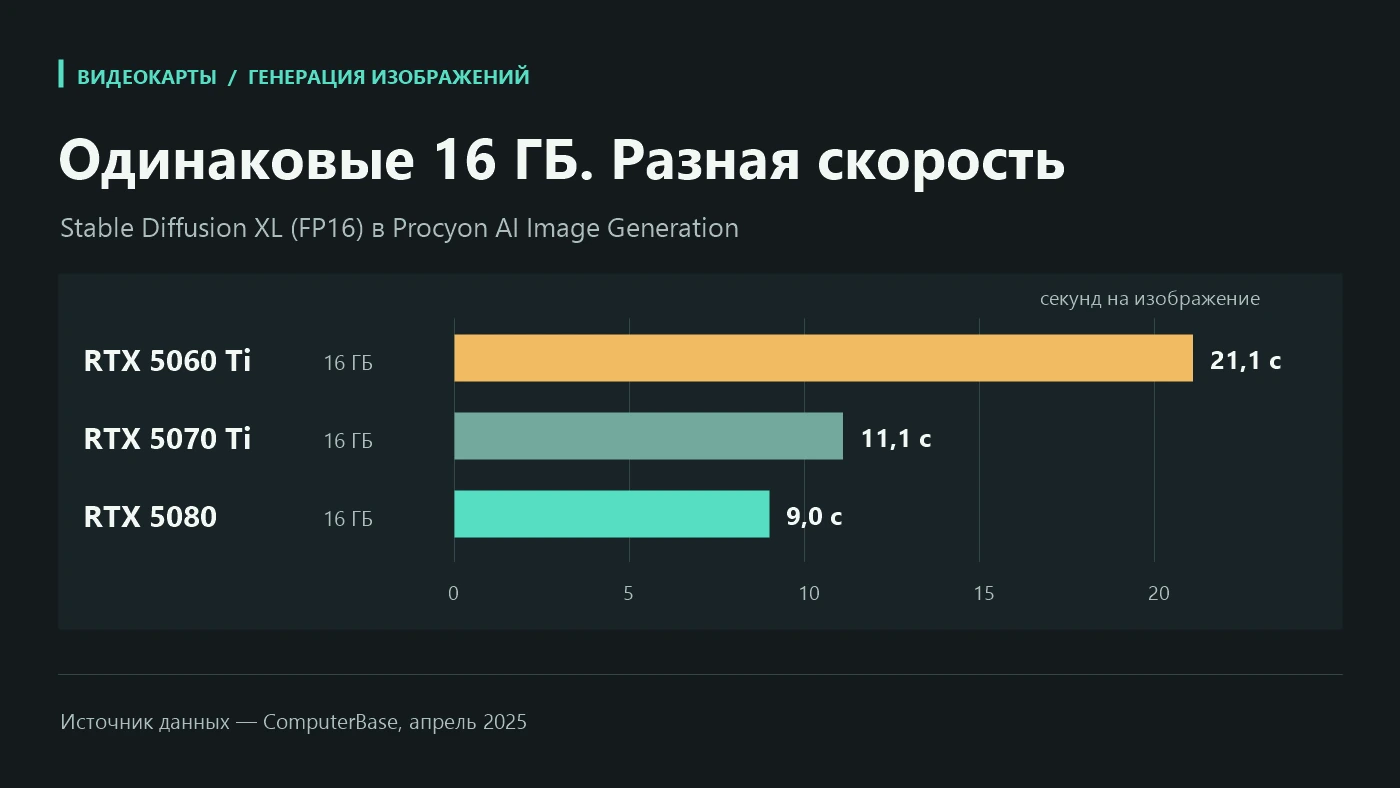
В тесте ComputerBase Procyon Stable Diffusion XL, FP16 с TensorRT на RTX 5060 Ti 16 ГБ уходило 21,1 секунды на изображение, на RTX 5070 Ti 16 ГБ — 11,1 секунды, на RTX 5080 16 ГБ — 9,0 секунды. У всех трёх карт по 16 ГБ VRAM, но в этом тесте две старшие справились примерно вдвое быстрее. В ComfyUI результат будет зависеть от модели и вашего графа. Результаты теста ComputerBase.
Пример 2. Карточка товара с референсом и финалом в 4K
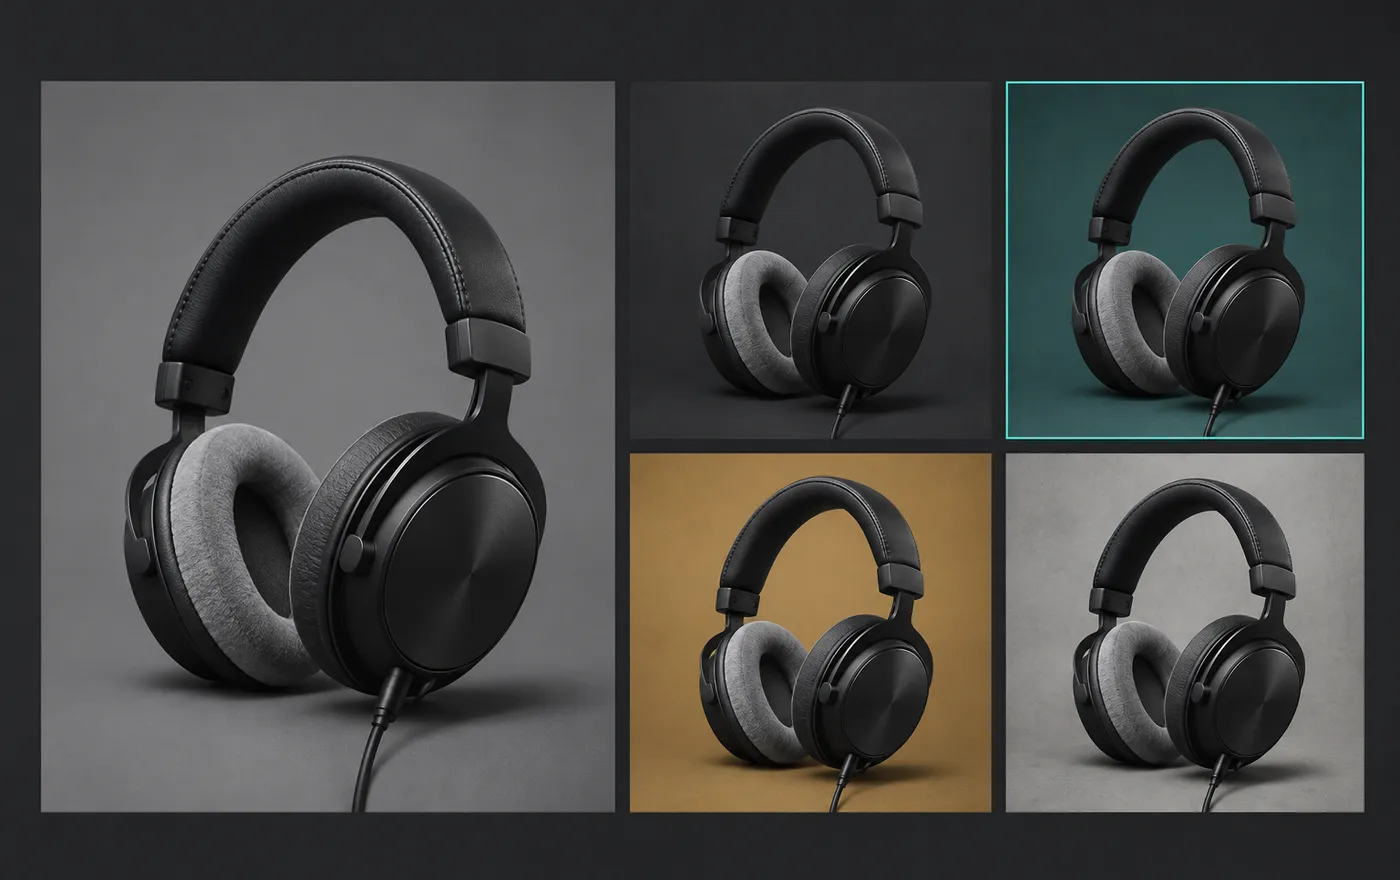
Есть фотография товара. Нужно сделать четыре варианта фона, сохранить форму и цвета предмета, выбрать один вариант и подготовить его в 4K. В ComfyUI я бы начал с FLUX 3 Image Klein INT8, одного референса и черновиков 1024 × 1024. Четыре задания ставим в очередь с batch_size=1. Получаем четыре варианта, а на этапе генерации движок держит активные данные для одного изображения за проход. Если стоит batch_size=4, четыре изображения считаются одним пакетом и пиковая потребность в памяти может вырасти. Когда памяти хватает, можно проверить, даёт ли пакет прирост по числу готовых кадров в минуту. Шаблон FLUX 3 Image Klein · Как размер пакета влияет на обработку изображений.
Референс сам по себе тоже нагружает карту. В FLUX 3 Image Klein изображение 1024 × 1024 даёт 4 096 токенов изображения. Референс такого же размера добавляет ещё 4 096 к последовательности, которую трансформер обрабатывает на каждом шаге. Если дать модели и фото товара, и несколько больших образцов фона, время может заметно вырасти даже при неизменном выходном размере. И наоборот, уместно обрезанный референс с нужной деталью порой позволяет решить ту же задачу проще. Главное проверить, что после обрезки модель всё ещё видит нужные форму, надписи или фактуру. Как FLUX 3 Image Klein обрабатывает пиксели и референсы.
Кадр 3840 × 2160 содержит примерно в 7,9 раза больше пикселей, чем черновик 1024 × 1024. Память и время не масштабируются строго с этим коэффициентом. Когда устраивают композиция и детали черновика, я бы увеличивал разрешение только выбранного кадра. Если сразу нужен кадр 16:9, разумно делать и черновик близким к 16:9, чтобы потом не переделывать композицию. А если задача в том, чтобы получить читаемую мелкую маркировку, отдельно сравните апскейл, дорисовку нужного участка и генерацию в большем разрешении. Апскейлер способен дорисовать убедительные детали, но надпись по-прежнему надо сверить с оригинальной фотографией. Апскейл в ComfyUI.
Что проверять, если закончилась видеопамять
| На каком этапе возникла проблема | Что я бы проверил первым |
|---|---|
| Загрузка весов | Открыта ли нужная версия модели. Для этого графа можно начать с INT8 вместо BF16 и проверить, помогает ли автоматическая выгрузка весов в RAM. |
| Генерация в sampler | Сколько изображений в пакете, какого размера выход и сколько референсов. Уменьшаем по одному параметру и повторяем прогон. Число шагов прежде всего влияет на время. |
|
| Пробуем |
| Отдельный апскейл | Проверяем, работает ли апскейлер по плиткам и какой размер подаётся на вход. Замеряем этот шаг отдельно от генерации. |
Загрузка моделей и Dynamic VRAM в ComfyUI · Узел VAE Decode (Tiled) · Апскейл в ComfyUI.
Когда граф стабильно работает на 16 ГБ, следующий вопрос — сколько времени уходит на всю карточку. Для сравнения RTX 5060 Ti 16 ГБ и RTX 5070 Ti 16 ГБ я бы взял один граф, одинаковую версию модели, референсы, разрешение и число шагов. Отдельно засёк бы первый запуск после загрузки программы и серию последующих прогонов. На обеих картах использовал бы одну и ту же последовательность seed, с новым seed для каждого прогона, чтобы очередь действительно пересчитывала результат. Если дороже всего обходится ожидание генерации, есть смысл в более быстром GPU. Если граф регулярно падает по памяти даже после настройки, переход с 16 на 16 ГБ объёма не добавит. Тогда сравниваем карты с большей VRAM уже на полном графе.
Видео
Ролик на несколько секунд можно сгенерировать и на сравнительно скромной карте. В документации ComfyUI есть сценарий Wan2.2 TI2V-5B для 8 ГБ VRAM с переносом компонентов в оперативную память. В собственном примере Wan-AI для этой модели при 1280 × 704 разработчики указывают от 24 ГБ для своей команды. Разница возникает из-за способа запуска, настроек и того, сколько данных в каждый момент держат на видеокарте. Шаблоны Wan2.2 в ComfyUI · Примеры запуска от Wan-AI.
Для ежедневной генерации я бы рассматривал 24–32 ГБ VRAM. Для рекомендуемой конфигурации LTX Desktop в Windows и Linux разработчик указывает 24 ГБ, а предпочтительным вариантом считает 32 ГБ. На 16 ГБ некоторые длинные клипы считаются по частям. Под конкретный проект нужно знать разрешение, число кадров, объём исходников и допустимое время на клип. Если после генерации вы ещё монтируете ролики, отдельно проверьте требования своего редактора. Системные требования LTX Desktop · Компьютер для DaVinci Resolve и Premiere Pro.
Пример 3. Сделать рекламный ролик из фотографии
Возьмём предметный ролик. Есть фотография собранного компьютера, на выходе нужен короткий проезд камеры. Для первого прогона в Wan2.2 TI2V-5B я бы проверил на коротком клипе, держит ли модель геометрию корпуса и не меняет ли расположение вентиляторов по ходу движения. Затем отдельно поднимал бы разрешение и длину. Если поменять всё сразу, при ошибке или резком замедлении сложнее понять, какой параметр оказался критичным. Шаблон Wan2.2 TI2V-5B для ComfyUI.
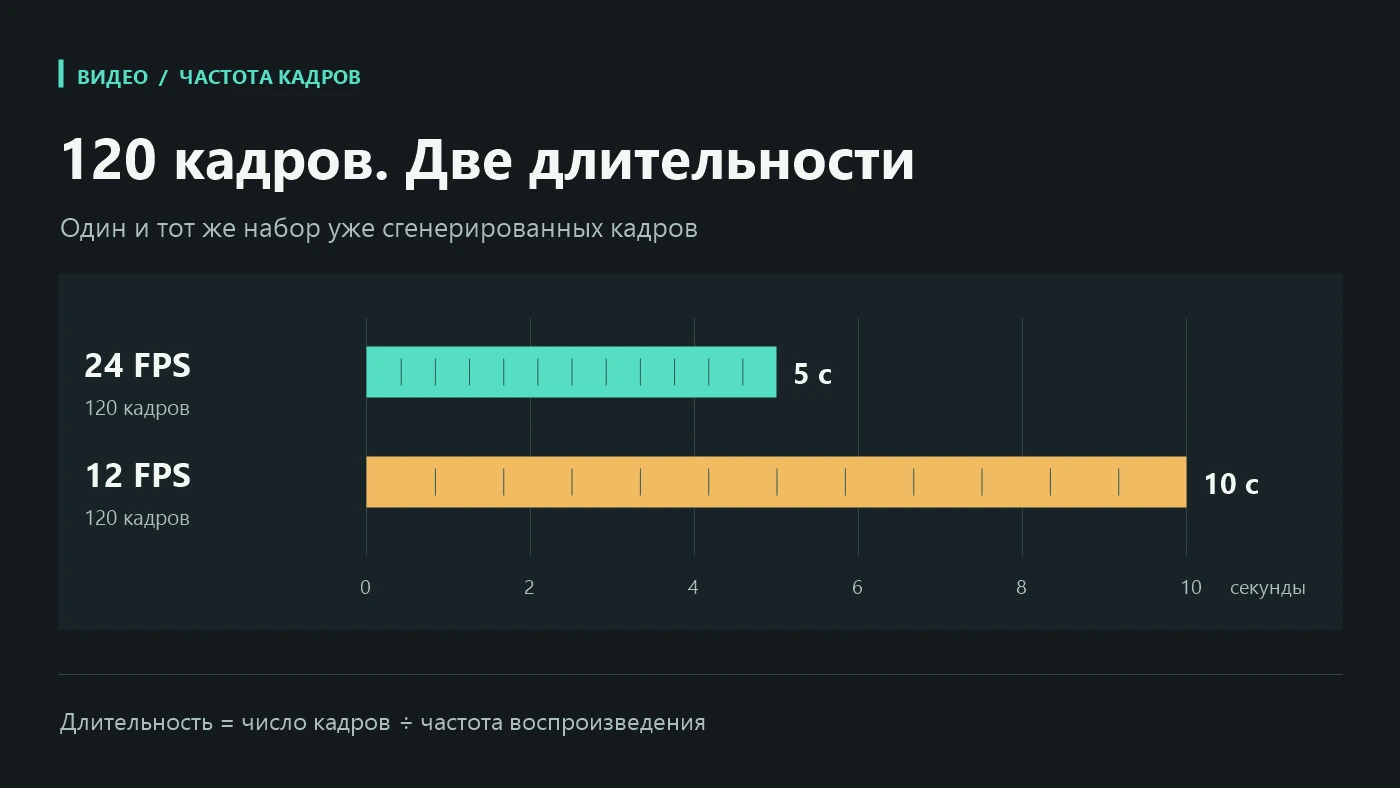
Число кадров и FPS — разные настройки. В шаблоне Wan2.2 узел Wan22ImageToVideoLatent задаёт размер и длину последовательности, которую считает модель. При сборке готового файла частота кадров задаёт скорость воспроизведения. Возьмём уже рассчитанные 120 кадров. При выводе в 24 FPS это 5 секунд, при 12 FPS — 10 секунд. Работу генератора это не меняет, потому что 120 кадров уже посчитаны. Если хотим облегчить сам расчёт, уменьшаем число генерируемых кадров или исходное разрешение в графе. Для реального запуска выбираем значения, которые поддерживает конкретная модель. Параметры графа Wan2.2 · Режимы Wan2.2 TI2V-5B.
Откуда берётся разница между «запустилось» и «можно делать ролики каждый день». Сначала граф загружает нужные модели и кодирует текст и исходник. Затем sampler последовательно обновляет скрытое представление будущего ролика, а VAE превращает его в кадры. Дальше кадры сохраняются в видеофайл. Если падает sampler, начинаем с длины и разрешения. Если он закончил и ошибка возникает при декодировании, в совместимом графе ComfyUI можно попробовать VAE Decode (Tiled) и уменьшить размер временного блока. При удачном результате проверяем переходы между блоками. Если дольше всего идёт сохранение, смотрим на кодек, настройки кодирования и накопитель. Покупка видеокарты по времени одного только экспорта тут мало что скажет. Декодирование видео блоками в ComfyUI.
Для ориентира Lightricks приводит конкретный пример LTX Desktop Fast. Карта с 16 ГБ может собрать 20 секунд в 720p в двух частях или 10 секунд в 1080p в трёх. Если сценарий требует одного длинного непрерывного движения, после такого прогона отдельно проверяем стыки и стабильность объекта между частями. Если же ролик всё равно монтируется из отдельных коротких планов, можно считать эти планы отдельно и оставить бюджет на что-то другое. Системные требования и режимы LTX Desktop.
Как выбрать между 16, 32 и 48 ГБ на практике. Я бы задал один рабочий проект и одно требование по срокам. Например, из одного исходника за смену нужно получить три пригодных дубля в заданном разрешении. На 16 ГБ проверяем, сколько времени уходит с выгрузкой и годятся ли короткие проходы. Если итоговое качество устраивает, но прогоны слишком долгие, сравниваем тот же граф на RTX 5090 32 ГБ и смотрим, где сократилось ожидание. Если даже на 32 ГБ для нужной длины или модели приходится урезать граф, в тест имеет смысл добавить NVIDIA RTX PRO 5000 48G. Запишите время полного прогона, пик VRAM и число пригодных дублей из одинаковой серии. Если один удачный дубль из пяти занял три минуты, на всю серию уйдёт около пятнадцати минут, если все прогоны одинаковы по длительности. Именно это время надо закладывать в производство.
Расшифровка записей
Для интервью и созвонов требования обычно скромнее. OpenAI указывает около 6 ГБ видеопамяти для Whisper Turbo и около 10 ГБ для Large в своей реализации. Если к расшифровке добавляются распознавание спикеров, обработка десятков записей одновременно и подготовка выжимки локальной языковой моделью, оцените каждую часть процесса и решите, что будет работать одновременно. Модели и требования Whisper.
Подойдёт ли этот ПК для обучения нейросетей
Запустить готовую модель, дообучить её и обучить с нуля — три разных нагрузки. При обычном запуске модель хранит веса и данные, нужные для вычислений. При полном обучении добавляются градиенты, состояние оптимизатора и активации, которые понадобятся для обратного прохода. Поэтому размер скачанного файла почти ничего не говорит о том, сколько памяти понадобится на обучение. Из чего складывается потребление памяти при обучении в Transformers.
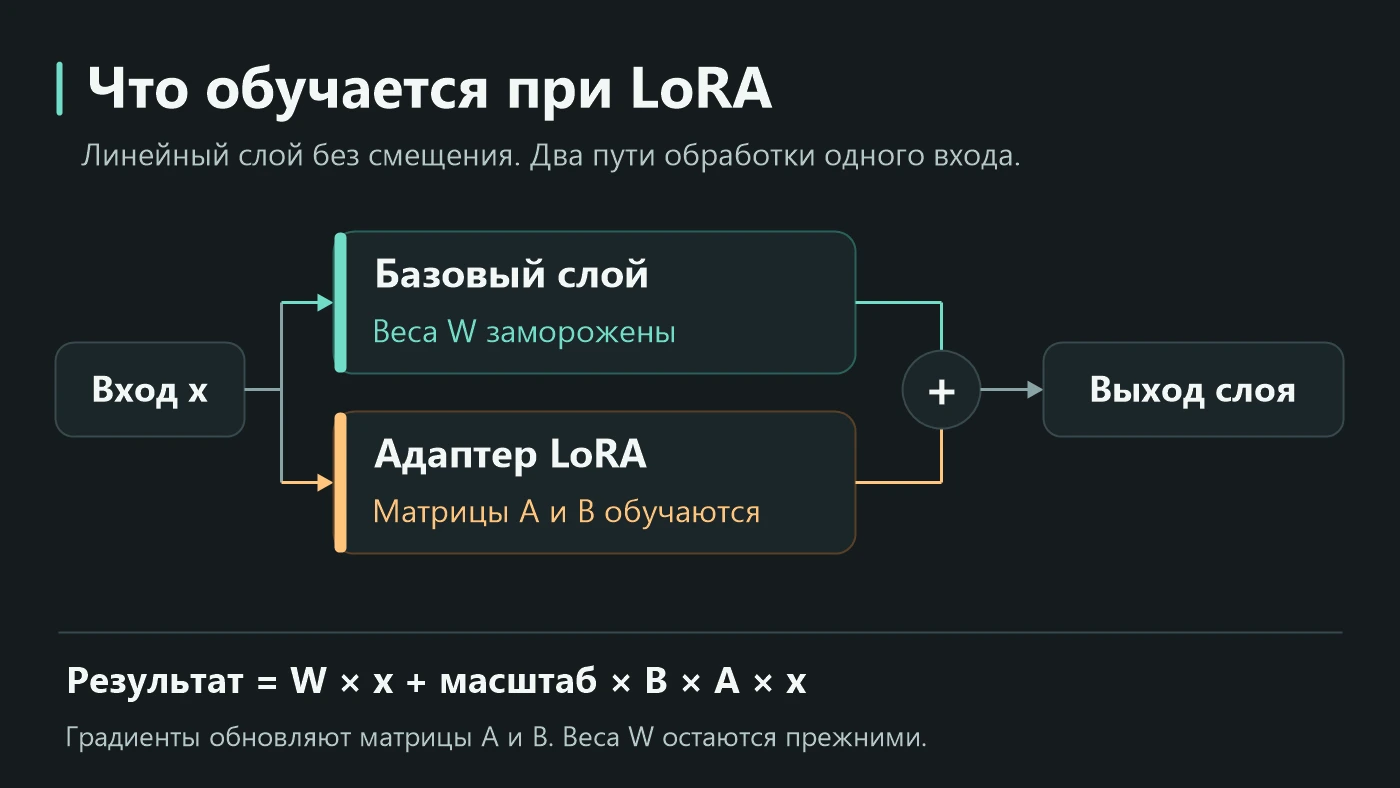
Для локальных экспериментов чаще уместна LoRA. Веса исходной модели заморожены, а обучаются добавленные адаптеры. В QLoRA замороженную модель дополнительно загружают в квантованном виде. Это помогает уложиться в меньший объём памяти, но выбирать карту надо по конкретному рецепту. Например, для LoRA на FLUX.2 Klein Base Black Forest Labs приводит 12 ГБ VRAM для версии 4B и около 22 ГБ для 9B. Это разные версии одной линейки, а требования уже почти вдвое отличаются. Black Forest Labs о дообучении FLUX.2 Klein · Описание QLoRA.
Что указать перед подбором ПК под LoRA
Фраза «буду обучать LoRA» оставляет слишком много неизвестных. Я бы попросил название базовой модели, ссылку на тренер, формат весов, размер входных данных и типичные настройки. Для языковой модели важна длина последовательности. Для модели изображений важны разрешение и то, какие компоненты вы дообучаете. В обоих случаях на пик памяти влияет, сколько примеров проходит через модель за один шаг.
Допустим, вы хотите дообучить стиль для изображений. Сначала запускаем короткий тест с тем же разрешением и набором компонентов, что будут в рабочем запуске. Проверяем, что проходит полный шаг обучения с обратным проходом и обновлением адаптера. То, что базовая модель поместилась в VRAM при генерации картинки, ничего не говорит о размере активаций во время обучения. Если памяти не хватает, можно уменьшить число примеров за проход и накапливать градиенты за несколько проходов. Другой способ — gradient checkpointing. Он позволяет хранить меньше промежуточных результатов и пересчитывать часть из них при обратном проходе. Оба варианта надо оценивать по реальному времени обучения. Из чего складывается память при обучении · Способы уменьшить расход памяти при обучении.
До покупки я бы записал расход видеопамяти и время нескольких шагов после прогрева. Затем отдельно проверил сохранение чекпойнта и генерацию пробного изображения, если тренер делает её по ходу обучения. Иногда основной цикл работает, а память заканчивается при проверочной генерации, когда тренер продолжает держать свои данные на GPU. По одному успешному запуску судить рано. Для выбора между 16, 32 и 48 ГБ полезнее короткий прогон с вашими настройками, чем список моделей, которые в принципе умеет запускать карта.
NVIDIA или AMD для локального ИИ
Для универсальной станции под Ollama, ComfyUI и PyTorch я бы начал с GeForce RTX. Многие готовые инструкции используют CUDA. При подборе новой карты сверяйте версии драйвера, PyTorch и расширений проекта.
У AMD есть карты с интересным объёмом памяти, например Radeon AI Pro R9700 с 32 ГБ. Она имеет смысл, когда нужный набор программ проверен. В списке Ollama R9700 есть среди карт для Linux с ROCm. Для Windows с ROCm перечень другой, и R9700 в нём отсутствует. Если проект состоит из нескольких частей, проверьте и сам движок, и дополнительные узлы. Спецификация AMD R9700 · Поддержка GPU в Ollama · Установка PyTorch под разные платформы.
У NVIDIA тоже легко промахнуться с названием. RTX 5060 Ti бывает на 8 и 16 ГБ. У RTX 5070 — 12 ГБ, у RTX 5070 Ti и RTX 5080 — 16 ГБ, у RTX 5090 — 32 ГБ. У NVIDIA RTX PRO 5000 48G — 48 ГБ. Если вопрос в том, поместится ли модель целиком, RTX 5060 Ti 16 ГБ может оказаться удобнее RTX 5070 12 ГБ. Если ваша модель свободно помещается на обеих картах, дальше уже сравниваем скорость. RTX 5060 Ti · RTX 5070 и 5070 Ti · RTX 5080 · RTX 5090 · NVIDIA RTX PRO 5000 48G.
Как подобрать процессор, оперативную память и SSD
Процессор. Для генерации на одной видеокарте я бы начал с современного Ryzen или Intel Core Ultra 5 / 7. Доплачивать за Ryzen / Ultra 9 имеет смысл, когда параллельно идёт подготовка больших датасетов, декодирование видео или другая тяжёлая работа на CPU. Если вы планируете держать значительную часть языковой модели в оперативной памяти, на результат влияют и пропускная способность памяти, и доля вычислений на процессоре. Покупку дорогого CPU под этот сценарий лучше проверять на конкретной модели.
Оперативная память. 32 ГБ — отправная точка для ПК с одной картой на 16 ГБ и умеренной нагрузкой. 64 ГБ я бы выбрал под регулярную работу в ComfyUI, обработку видео, локальный поиск по документам и ситуации, когда часть компонентов модели выгружается с GPU. 96–128 ГБ имеют смысл при больших наборах данных, нескольких одновременных процессах или постоянной работе с выгрузкой. Дополнительная RAM помогает загрузить более тяжёлую модель, а скорость зависит от того, какая её часть остаётся на GPU. Выгрузка компонентов модели в Diffusers.
SSD. Для нового компьютера под локальные модели я бы поставил NVMe на 2 ТБ. Если делаете видео и храните несколько версий моделей, берите 4 ТБ или оставляйте свободный M.2. Один только шаблон ComfyUI для Wan2.2 14B T2V использует два файла FP8 по 14,3 ГБ, плюс отдельные файлы текстового энкодера и декодера. А потом появятся другие модели, исходники и папка с результатами. Шаблон Wan2.2 14B T2V · Размеры файлов.
Охлаждение и питание. У RTX 5090 референсное энергопотребление самой карты составляет 575 Вт. Для NVIDIA RTX PRO 5000 48G производитель указывает максимум 300 Вт. Система, которая часами генерирует видео, должна нормально отводить тепло и оставаться приемлемой по шуму. Я бы смотрел на корпус с хорошим притоком воздуха, проверял размеры карты вместе с кабелем питания и выбирал блок питания по конкретной модификации GPU и остальной сборке. Для флагманской сборки ниже с RTX 5090 я бы взял качественный ATX 3.1 на 1200 Вт. Для варианта с NVIDIA RTX PRO 5000 48G хватит диапазона 850–1000 Вт при указанной конфигурации. Спецификации и рекомендации NVIDIA · Спецификация NVIDIA RTX PRO 5000 48G · Как выбрать блок питания для компьютера.
Что происходит, когда Ollama и ComfyUI работают вместе
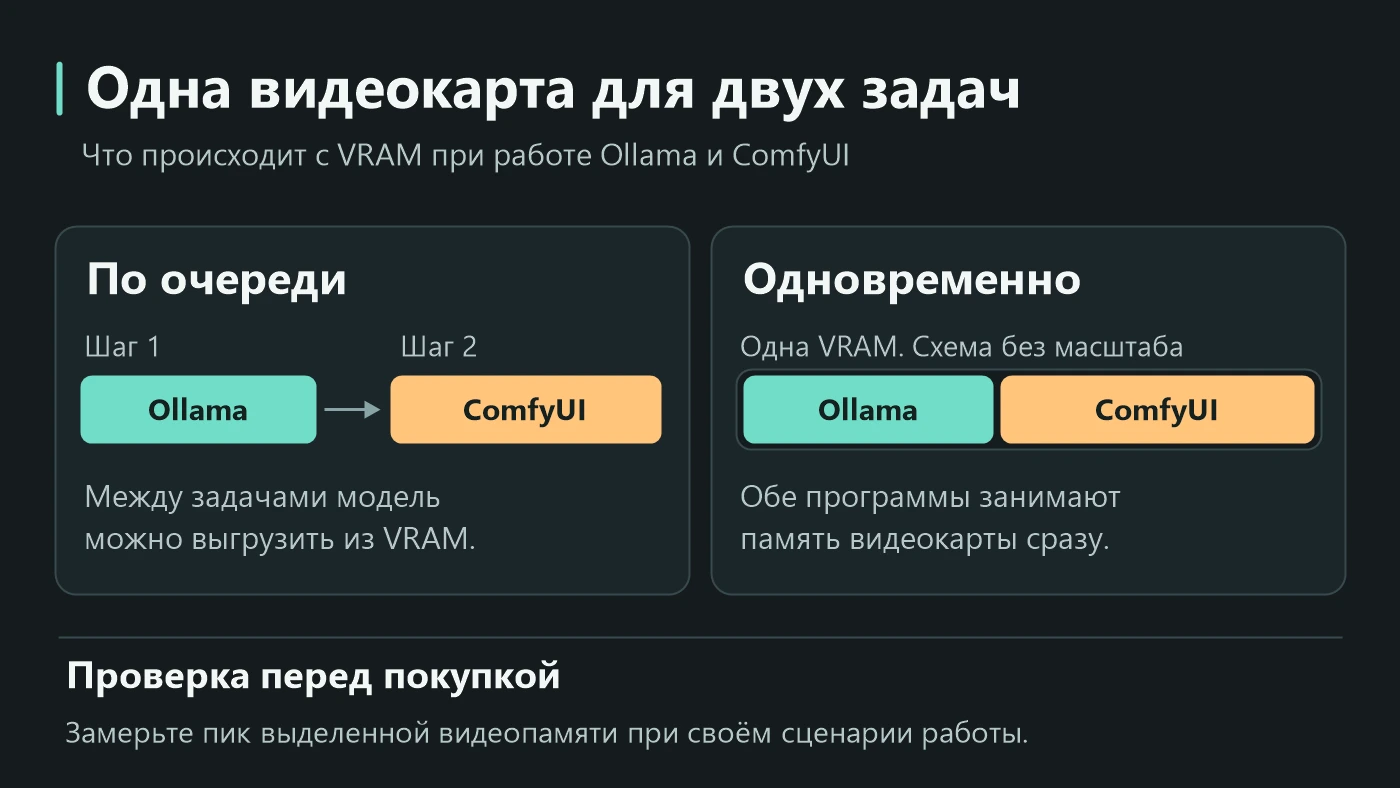
Допустим, локальный чат пишет описания товаров, а ComfyUI в это время генерирует картинки. Даже после ответа Ollama по умолчанию держит модель в памяти ещё пять минут. Если граф вдруг перестал помещаться в VRAM, откройте ollama ps и посмотрите столбец PROCESSOR. Если задачи можно выполнять по очереди, ollama stop <имя модели> выгрузит модель. Следующий запрос загрузит её заново. Через API можно задать keep_alive: 0, чтобы освобождать память после ответа. Если чат должен отвечать во время генерации, тестируйте оба приложения одновременно. Замерьте пик выделенной видеопамяти и время ответа чата при работающем графе. Управление загрузкой модели в Ollama · Как Windows показывает видеопамять.
Если первая попытка после запуска долгая, а следующие идут быстрее, отдельно замерьте загрузку весов. В API Ollama это load_duration. При планировании SSD сложите модели, исходники, промежуточные файлы и готовые результаты. Только три версии Qwen3-32B из примера выше занимают на диске 77,8 ГБ. Проверьте, где фактически лежат веса. Если Ollama продолжает писать их на системный диск, большой второй SSD сам по себе ситуацию не изменит. Каталог моделей можно задать через OLLAMA_MODELS. Время загрузки в API Ollama · Каталог моделей Ollama.
Три примера конфигураций для работы с ИИ
Простая сборка для локального чата, картинок и аудио
| Компонент | Что предлагаю |
|---|---|
| Процессор | AMD Ryzen 5 9600X или Intel Core Ultra 5 225 |
| Материнская плата | B650 для AMD, B860 для Intel |
| Оперативная память | 32 ГБ DDR5, 2 × 16 ГБ |
| Видеокарта | GeForce RTX 5060 Ti, 16 ГБ |
| SSD | NVMe, 2 ТБ |
| Охлаждение | Башенный кулер |
| Блок питания | 650 Вт |
| Корпус | С нормальным притоком воздуха |
С такой сборки я бы начал, если нужен локальный чат для одного человека, расшифровка аудио и периодическая работа в ComfyUI. Выбирайте именно 16-гигабайтную версию RTX 5060 Ti. Для облачного ChatGPT и генерации в браузере можно вообще обойтись без дискретной карты.
Средняя сборка для ежедневной работы с ИИ
| Компонент | Что предлагаю |
|---|---|
| Процессор | AMD Ryzen 7 9700X или Intel Core Ultra 5 250K Plus |
| Материнская плата | B650 или B850 для AMD, B860 для Intel |
| Оперативная память | 64 ГБ DDR5, 2 × 32 ГБ |
| Видеокарта | GeForce RTX 5070 Ti, 16 ГБ, или NVIDIA RTX PRO 4000 Blackwell, 24 ГБ |
| SSD | NVMe, 2 ТБ. Для библиотеки моделей и видео можно взять 4 ТБ |
| Охлаждение | Двухбашенный кулер |
| Блок питания | 850 Вт |
| Корпус | С хорошим притоком воздуха и местом для полноразмерной видеокарты |
Если рабочий граф помещается в 16 ГБ и нужно быстрее делать пачки изображений, я бы начал с RTX 5070 Ti. Если нужна модель уровня Qwen3-32B в Q4 с умеренным контекстом или граф ComfyUI регулярно упирается в 16 ГБ, рассмотрите RTX PRO 4000 Blackwell на 24 ГБ. Проверьте на своём графе, что дают дополнительные 8 ГБ и сколько занимает полный прогон. GeForce RTX 5070 Ti · NVIDIA RTX PRO 4000 Blackwell.
Флагманская станция для крупных моделей, видео и дообучения
| Компонент | Что предлагаю |
|---|---|
| Процессор | AMD Ryzen 9 9950X или Intel Core Ultra 7 270K Plus / Intel Core Ultra 9 285K |
| Материнская плата | B850 или X870 для AMD, Z890 для Intel |
| Оперативная память | 96 ГБ DDR5, 2 × 48 ГБ. Для больших датасетов и параллельных задач — 128 ГБ, 2 × 64 ГБ |
| Видеокарта | GeForce RTX 5090, 32 ГБ, или NVIDIA RTX PRO 5000 48G. Если задаче нужны 96 ГБ на одной карте — NVIDIA RTX PRO 6000 Blackwell Workstation Edition |
| SSD | NVMe, 4 ТБ. Для больших архивов и исходников можно добавить второй SSD |
| Охлаждение | Мощный двухбашенный кулер или СЖО 360 мм |
| Блок питания | 1200 Вт ATX 3.1 для RTX 5090 или RTX PRO 6000 Workstation Edition. Для NVIDIA RTX PRO 5000 48G — 850–1000 Вт |
| Корпус | Просторный, с хорошей вентиляцией под длительную нагрузку |
RTX 5090 я бы выбрал, если вся задача помещается в 32 ГБ и важна скорость. NVIDIA RTX PRO 5000 48G имеет смысл, когда нужны более крупные модели, длинный контекст, одновременные запросы или видео, которое приходится урезать на 32 ГБ. Есть и версия RTX PRO 5000 на 72 ГБ. RTX PRO 6000 на 96 ГБ стоит рассматривать, когда расчёт или пробный прогон показывает, зачем вам весь этот объём на одной карте. GeForce RTX 5090 · NVIDIA RTX PRO 5000 Blackwell · NVIDIA RTX PRO 6000 Blackwell.
Если вы подбираете один компьютер и для генерации, и для 3D, посмотрите, какая часть работы в вашем 3D-пакете достанется процессору. В Corona и V-Ray GPU, например, бюджет распределяется по-разному. Компьютер для 3ds Max, Corona и V-Ray · Примеры сборок «Пульс ПК».
Когда вторая видеокарта действительно помогает
Я бы начал с вопроса, зачем нужна вторая карта. Если два человека независимо генерируют картинки, можно запустить по отдельному процессу на каждом GPU. Тогда каждый выполняет свои задания и живёт в пределах собственной видеопамяти. Если же на одной карте не помещается модель, нам нужна поддержка распределения одной модели по нескольким GPU. Здесь важны движок, режим распределения и связь между картами. Как llama.cpp распределяет модель между GPU.
Например, два GPU по 32 ГБ физически имеют 64 ГБ памяти, распределённой по двум картам. Движок может разнести слои и их кэш между GPU. В другом режиме он делит вычисления внутри слоёв. Карты чаще обмениваются промежуточными результатами и сильнее зависят от пропускной способности соединения. Из-за этого две карты под одной моделью могут дать совсем другой выигрыш, чем те же две карты под независимыми задачами. Для одного процесса с большим объёмом данных карту с 48 ГБ или 96 ГБ полезно рассмотреть ещё на этапе выбора платформы. Режимы распределения в llama.cpp · Параллельная работа в vLLM.
Две RTX 5090 дают до 1 150 Вт по сумме заявленных мощностей самих карт, две NVIDIA RTX PRO 5000 48G — до 600 Вт. Для такой станции отдельно считаем полную нагрузку на блок питания и проверяем, хватает ли места и обдува обеим картам. GeForce RTX 5090 · NVIDIA RTX PRO 5000 48G.
Частые вопросы
Складывается ли память двух видеокарт?
Для одной модели память двух карт можно использовать, если движок умеет распределять веса между ними. Ollama при возможности размещает модель целиком на одной карте, а если она туда не помещается, может распределить её по нескольким. FAQ Ollama · Распределение модели в llama.cpp.
Стоит ли брать б/у RTX 3090 ради 24 ГБ?
Да, если нужная модель выходит за пределы 16 ГБ, а цена и состояние карты устраивают. Сравните её с доступными картами на 24–32 ГБ по своему сценарию, расходам на питание и охлаждение. У подержанной карты я бы проверил стабильность под длительной нагрузкой, температуры и вентиляторы. Спецификация RTX 3090.
Нужен ли процессор с NPU?
Если покупаете компьютер под конкретное приложение, проверьте, умеет ли оно использовать NPU. Для приведённых здесь сценариев с GeForce RTX я бы закладывал бюджет под видеокарту, память и SSD. Наличие NPU само по себе не ускоряет граф ComfyUI или модель в Ollama.
Можно ли запускать нейросети на ноутбуке?
Для облачных сервисов подойдёт обычный ноутбук. Для локальной работы проверьте именно мобильную видеокарту и объём её памяти. Например, у настольной RTX 5090 32 ГБ, а у RTX 5090 Laptop GPU — 24 ГБ. Если для локальных моделей требуется больше памяти, один из вариантов для настольной станции — NVIDIA RTX PRO 5000 48G. Для генерации, которая длится часами, также имеет значение лимит мощности и то, как ноутбук охлаждается под постоянной нагрузкой. Настольная RTX 5090 · Мобильные GeForce RTX 50 · NVIDIA RTX PRO 5000 48G.
Что замерить на рабочей задаче перед покупкой
| Что проверить | Что записать |
|---|---|
| Локальная языковая модель | Модель, квантование, заданное окно, число одновременных запросов, долю GPU/CPU, время до первого видимого текста и время до конца ответа |
| Граф ComfyUI для изображений | Версию весов, выходной размер, референсы, пакет, число шагов, пик VRAM и время генерации с апскейлом |
| Видео из фотографии | Размер и число рассчитанных кадров, FPS на выходе, время одного полного прогона и число пригодных дублей |
| Дообучение адаптера | Базовую модель и тренер, размер входа, параметры пакета, пик VRAM и время шага после прогрева |
Если всё работает, но приходится долго ждать, сначала выясните, какой этап съедает время. На той же карте попробуйте изменить один параметр и повторить прогон. Для измерения общей нагрузки NVIDIA можно использовать nvidia-smi, например nvidia-smi --query-gpu=utilization.gpu,memory.used,memory.total --format=csv -lms 200. Это показывает занятость и память карты с шагом 200 мс, включая другие процессы. Короткий пик может попасть между опросами. Для языковой модели полезно одновременно смотреть распределение в Ollama, а в ComfyUI — этап, на котором идёт расчёт. Справочник NVIDIA System Management Interface · Проверка размещения модели в Ollama.
Как заказать компьютер для нейросетей
Если уже работаете с локальным ИИ, пришлите нам название модели и программы. Для языковой модели укажите обычный размер запроса и сколько человек будет работать одновременно. Для изображений и видео пригодится ваш граф ComfyUI или описание типичного проекта с разрешением, длительностью ролика и количеством вариантов в день. Если пока только начинаете, расскажите, какую работу хотите перенести на свой компьютер.
По этим данным в «Пульс ПК» подберём конфигурацию под ваш бюджет. Если вы хотите сохранить часть комплектующих, посмотрим, что даст апгрейд текущего ПК. Связаться с «Пульс ПК».
🤖 Эта статья полностью написана искусственным интеллектом.